产品功能
语义层 101:把业务口径写成文档,让数字员工按口径问数
同一个「合格率」,不同人算出不同数字,通常不是数据错了,而是口径没有写下来。语义层把统计对象、表间关系、编码含义和指标公式保存为资料库中的一份文档。本文按绑定数据源、授权、确认口径、审阅文档、按指标问数与诊断的顺序,说明这项功能怎么用、界面上看什么、哪些地方仍需人工确认。
制造企业的报表里,「本月各事业部报验合格率」这样一句话至少藏着四个决定:报验记录以哪张表为准;哪几个检验结论编码算合格;「本月」按报验日期还是录入日期;同一批次报验两次算一次还是两次。这些决定分散在各人的经验、表格公式和口头约定里,数字员工第一次接触数据源时并不知道。
源宜的语义层功能把这些决定写成一份保存在资料库里的文档。数字员工先扫描已授权的数据库结构,用只读查询核对取值分布,把确实不确定的口径提交给使用者确认,再把确认结果连同证据写进文档;之后的问数与诊断都按这份文档计算,结果附带查询对象、结构版本与来源,便于复核。
本文面向第一次使用这项功能的业务负责人与数据管理员,按实际操作顺序说明每一步在界面上看什么、需要做什么决定。截图来自源宜安装版在专门构造的质检示例数据上的演示,数值不代表任何客户的生产实绩。
「语义层」解决什么问题
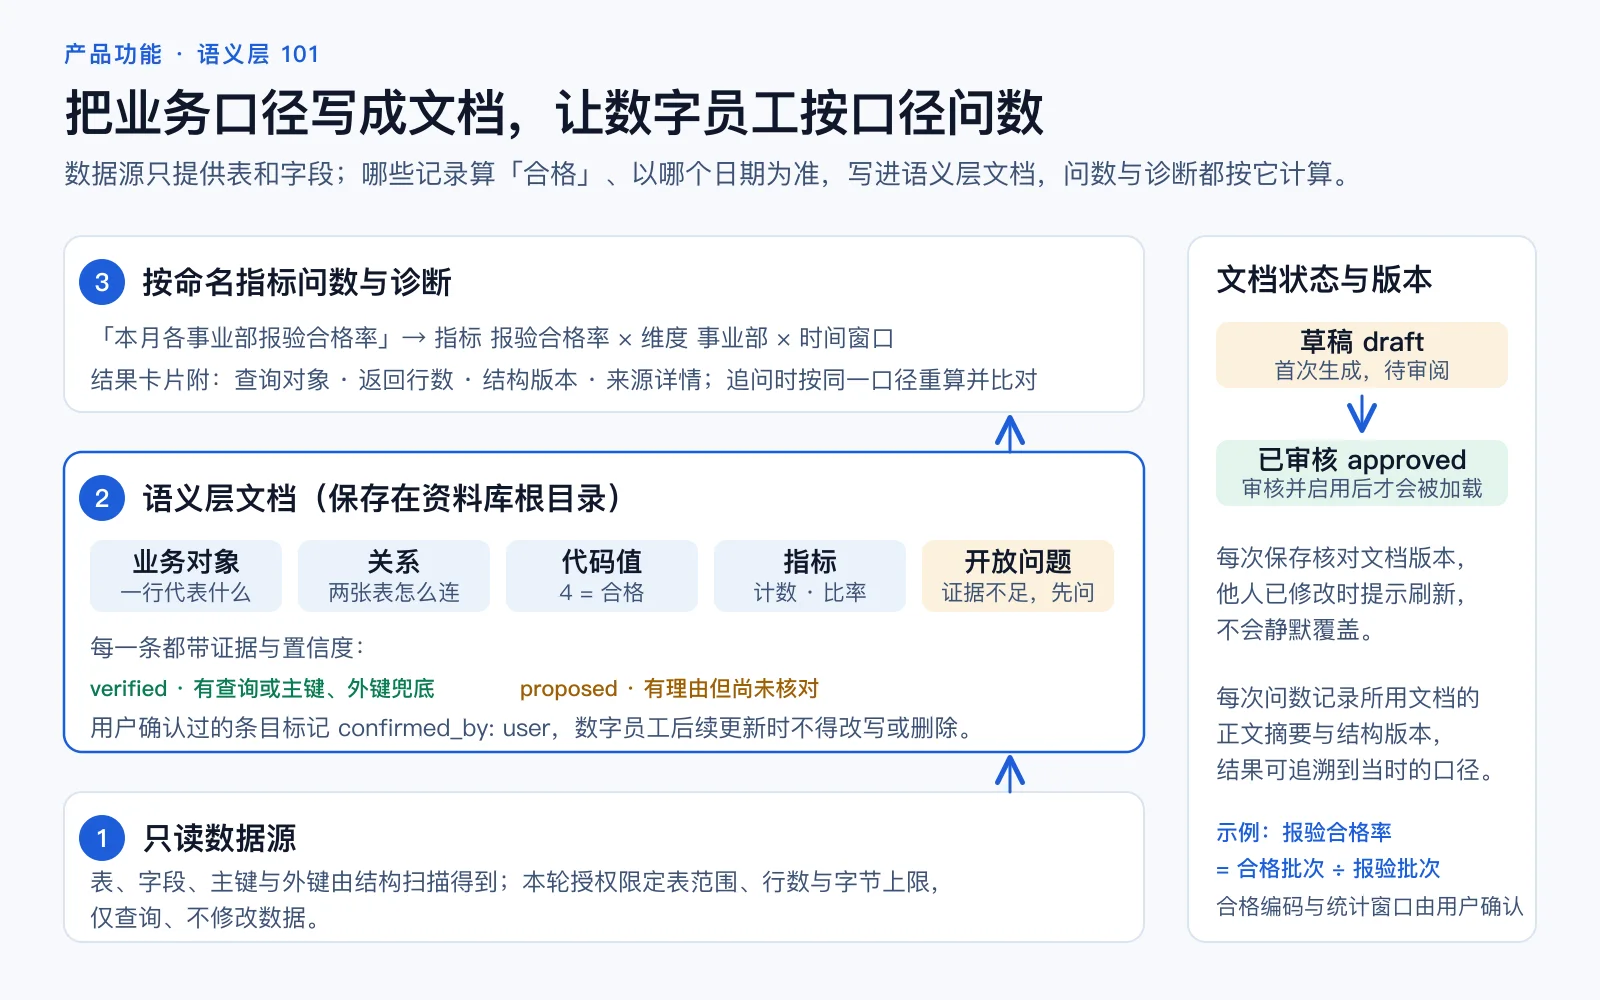
语义层不替业务做决定,它记录已经做出的决定,并让之后的每一次计算都按同一份记录执行。
数据库只提供表、字段和外键。它能告诉数字员工「检验结论」是一列整数,取值有 2、3、4,却不能说明哪个取值代表合格。同一份数据,一个人按「4 算合格」得到 33.3%,另一个人按「2、3、4 都算合格」得到 100%,两个数字都能从数据里算出来,差别只在口径。
语义层文档就是把这些口径写下来的地方:一行代表什么业务对象,两张表怎样关联,每个编码的业务含义,指标的分子、分母与时间字段,以及尚未确定、需要人工回答的问题。文档保存在数据源所在资料库的根目录,文件名为「数据源名-语义层.md」,有权限的同事都能打开阅读和修改。
与只在对话里临时约定相比,文档化的口径有三点不同:下一次问数不必重新解释;每条口径带着证据与置信度,能区分「查过」与「推测」;使用者确认过的条目受保护,数字员工后续更新时不会改写。
一份语义层文档里有什么
文档正文先用一段给人看的摘要说明结论、口径与样本量,再用一段结构化内容供数字员工读取。结构化部分分为六块:前两块可以由结构扫描直接起草,中间三块需要既有定义、当前数据源的查询证据或使用者确认,最后一块记录尚未解决的问题。
- 置信度只有两档:verified 表示有主键、外键或实际查询兜底;proposed 表示有理由但尚未核对。两者混在一起不加标注,比没有语义层更危险。
- 每条可标记确认人:confirmed_by 为 user 的条目由使用者确认,数字员工后续更新时不得修改、降级或删除;为 agent 的条目由数字员工写入,可以在新证据下改写。
- 没有证据的判断不写进正文,只进「开放问题」,等使用者回答后再补充。
| 部分 | 回答的问题 | 举例 |
|---|---|---|
| 来源与状态 | 文档对应哪个数据源、哪个结构版本,处于草稿还是已确认 | 数据源名称、结构哈希、状态 draft |
| 业务对象 | 一行代表什么,用哪个字段唯一标识,时间字段是哪个 | 报验批次:一行等于一个批次,时间字段为报验日期 |
| 关系 | 两张表通过哪些字段关联,是一对多还是多对一 | 报验批次到事业部为多对一,依据外键 |
| 代码值 | 枚举字段的每个取值代表什么业务含义 | 检验结论 4 为合格;2、3 为不合格(使用者确认) |
| 指标 | 计数或比率的分子、分母、筛选条件与时间字段 | 报验合格率等于合格批次数除以报验批次数 |
| 开放问题 | 证据不足、需要人工回答的事项 | 「本月」是否排除尚未完成检验的批次 |
准备:一个只读数据源和一个资料库
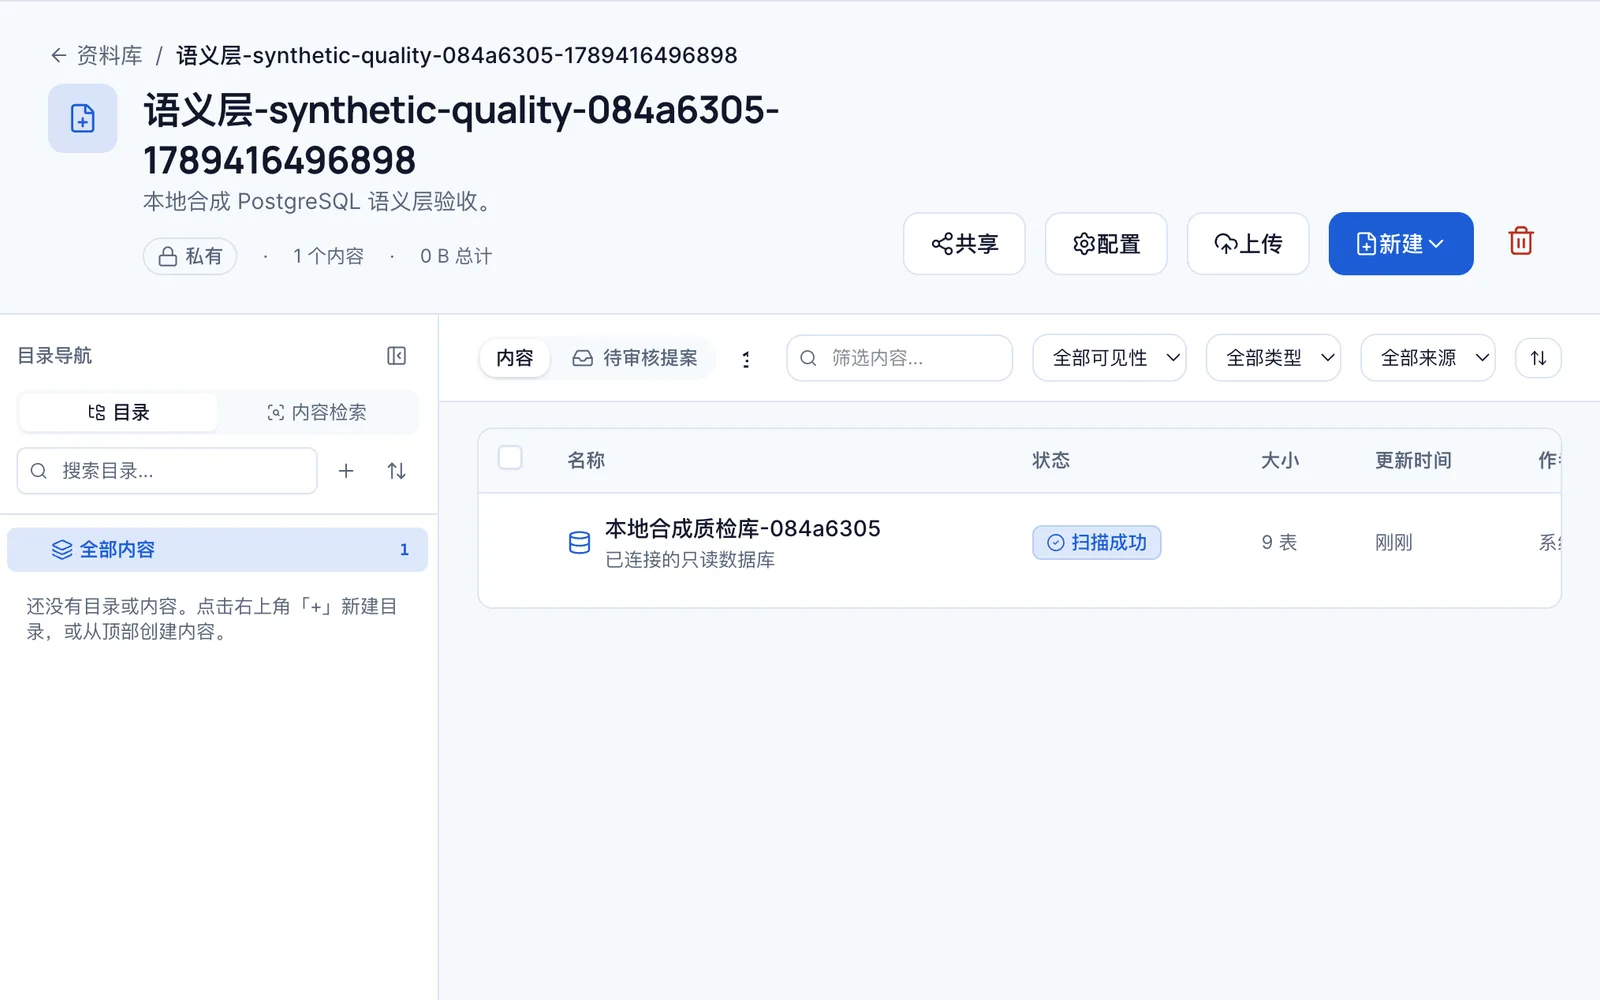
语义层依附于资料库中的数据源。在「资料库」中新建或选择一个资料库,绑定数据库连接后,系统会扫描表、字段、主键、外键与注释,列表中显示「已连接的只读数据库」和「扫描成功」。这一步只读取结构,不读取业务数据。
建议一个数据源对应一个资料库,并让负责该业务的人拥有编辑权限:语义层文档保存在这个资料库的根目录,后续的审阅、修改和审核都在这里完成。若资料库只有只读权限,数字员工会把文档作为可下载的文件交付,由使用者上传到资料库。
发起构建:一句话目标和一次只读授权
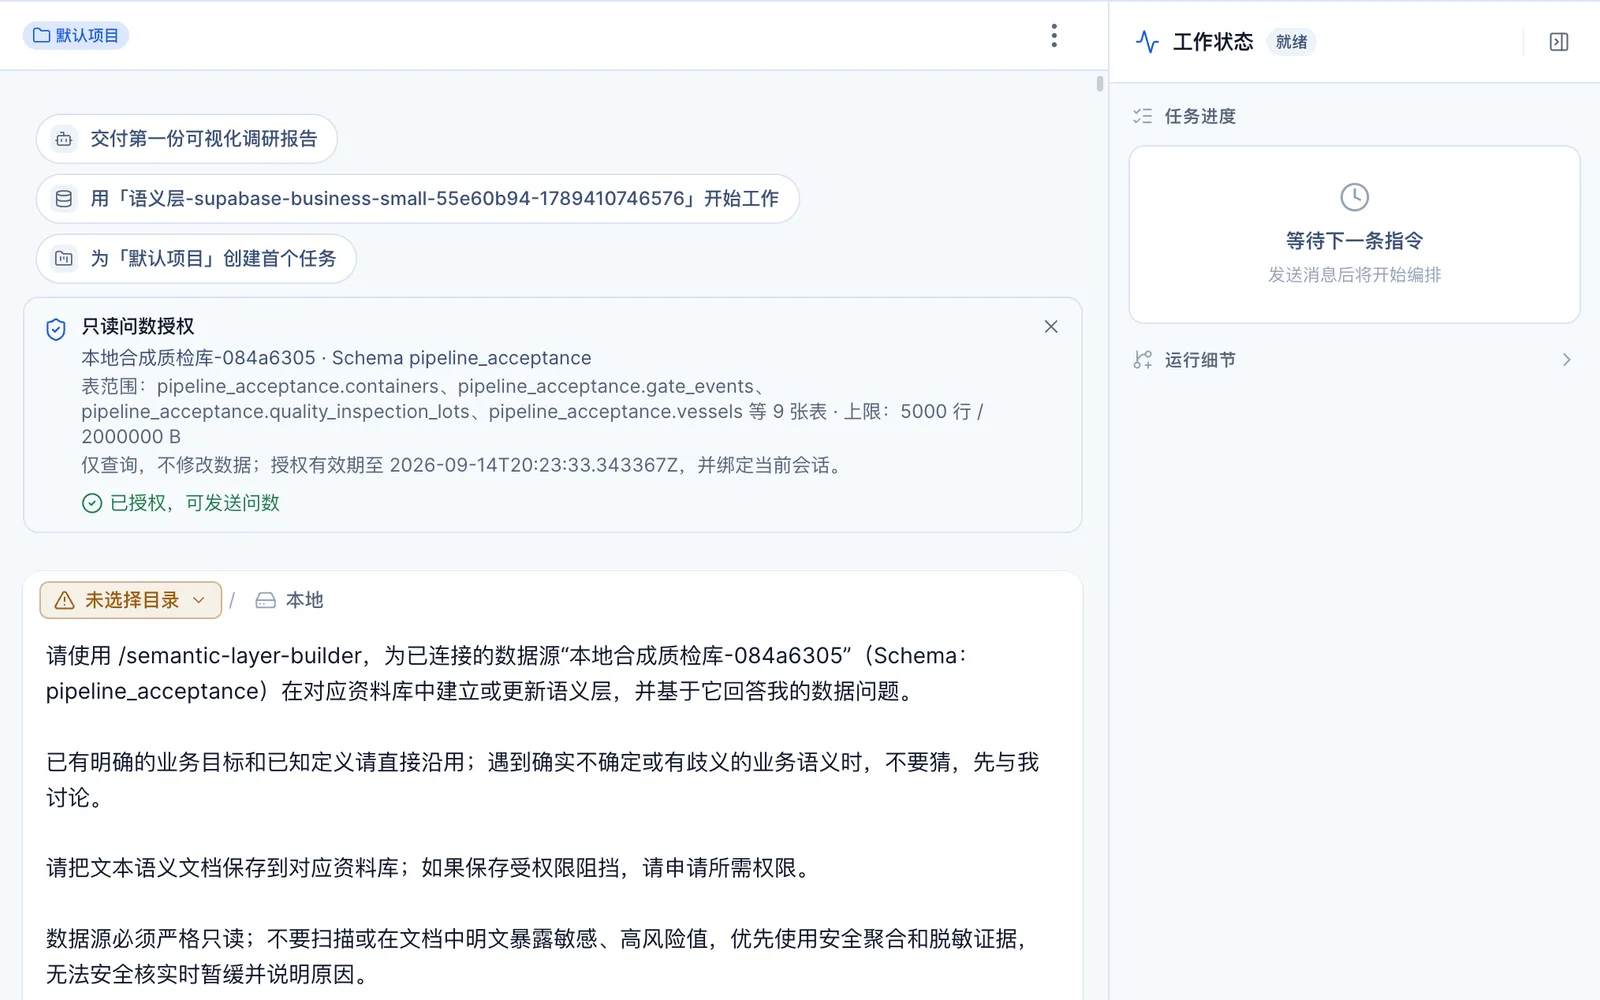
在对话中说明目标即可,例如「为已连接的数据源建立语义层,并回答本月各事业部报验合格率」。不需要预先写出字段名、公式或参考 SQL;如果已经有明确的定义,可以一并写出,数字员工会直接沿用而不再重复确认。
数字员工读取数据前会申请「只读问数授权」。卡片上写明数据源、Schema、允许查询的表、单次返回的行数与字节上限以及有效期;确认后显示「已授权,可发送问数」。授权绑定当前会话,到期后需要重新授权,界面会提示。
授权之后,数字员工按固定顺序工作:先在资料库里查找是否已有该数据源的语义层文档;再用授权范围内的结构起草业务对象与关系;然后用聚合查询核对取值分布与时间范围,形成指标草案。整个过程只发只读查询,不会把明细数据写进文档。
回答口径问题:只在真正不确定时提问
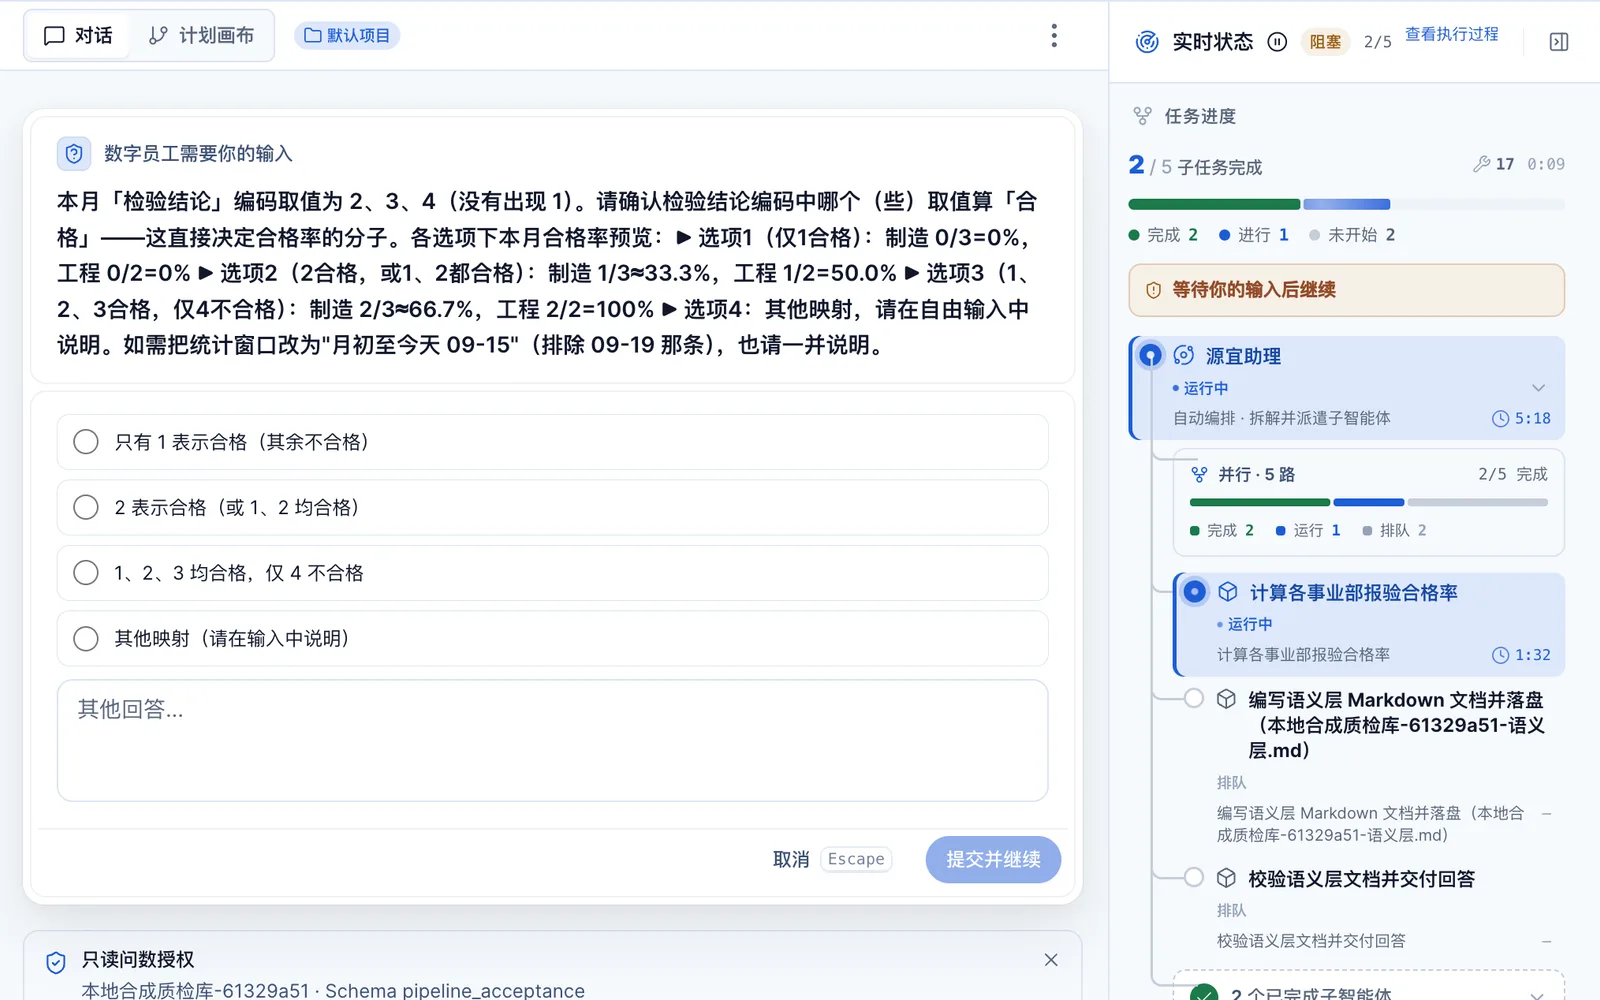
遇到会改变结果、而现有证据无法消除的歧义时,数字员工会暂停并显示「数字员工需要你的输入」。图中的例子是检验结论编码:数据里出现了 2、3、4 三种取值,哪些算合格直接决定合格率的分子。提问同时给出每个选项下的合格率预览,使用者可以直接判断哪一个符合本单位的规定。
已有明确定义的事项不会被重复询问;只影响展示方式、不改变口径的细节也不会打断流程。典型需要确认的三类问题是:指标的分子、分母与排除条件;没有外键时两张表的关联键;枚举值的业务含义。
使用者的回答会作为已确认条目写进文档,并标记 confirmed_by: user。如果暂时无法回答,可以在输入框中说明,数字员工会把它记入开放问题,按物理记录先给出可核对的统计,不替使用者做业务判断。
从绑定数据源到可复用的口径
- 01
绑定数据源
在资料库中连接只读数据库,等待结构扫描完成。
得到什么显示「扫描成功」的数据源
- 02
发起并授权
用一句话说明目标,确认只读问数授权。
得到什么「已授权,可发送问数」
- 03
画像与提问
数字员工核对取值分布,只对真正不确定的口径提问。
得到什么带预览的确认卡片
- 04
生成文档
口径连同证据、置信度写入语义层文档并保存到资料库。
得到什么资料库中的草稿文档
- 05
审阅与审核
负责人在资料库中阅读、修改,审核后启用。
得到什么已审核且启用的文档
- 06
问数与诊断
按命名指标提问,追问时按同一口径重算并比对。
得到什么附结构版本与来源的结果
文档里的口径与本单位规定一致吗?
审阅语义层文档:草稿、审核与版本
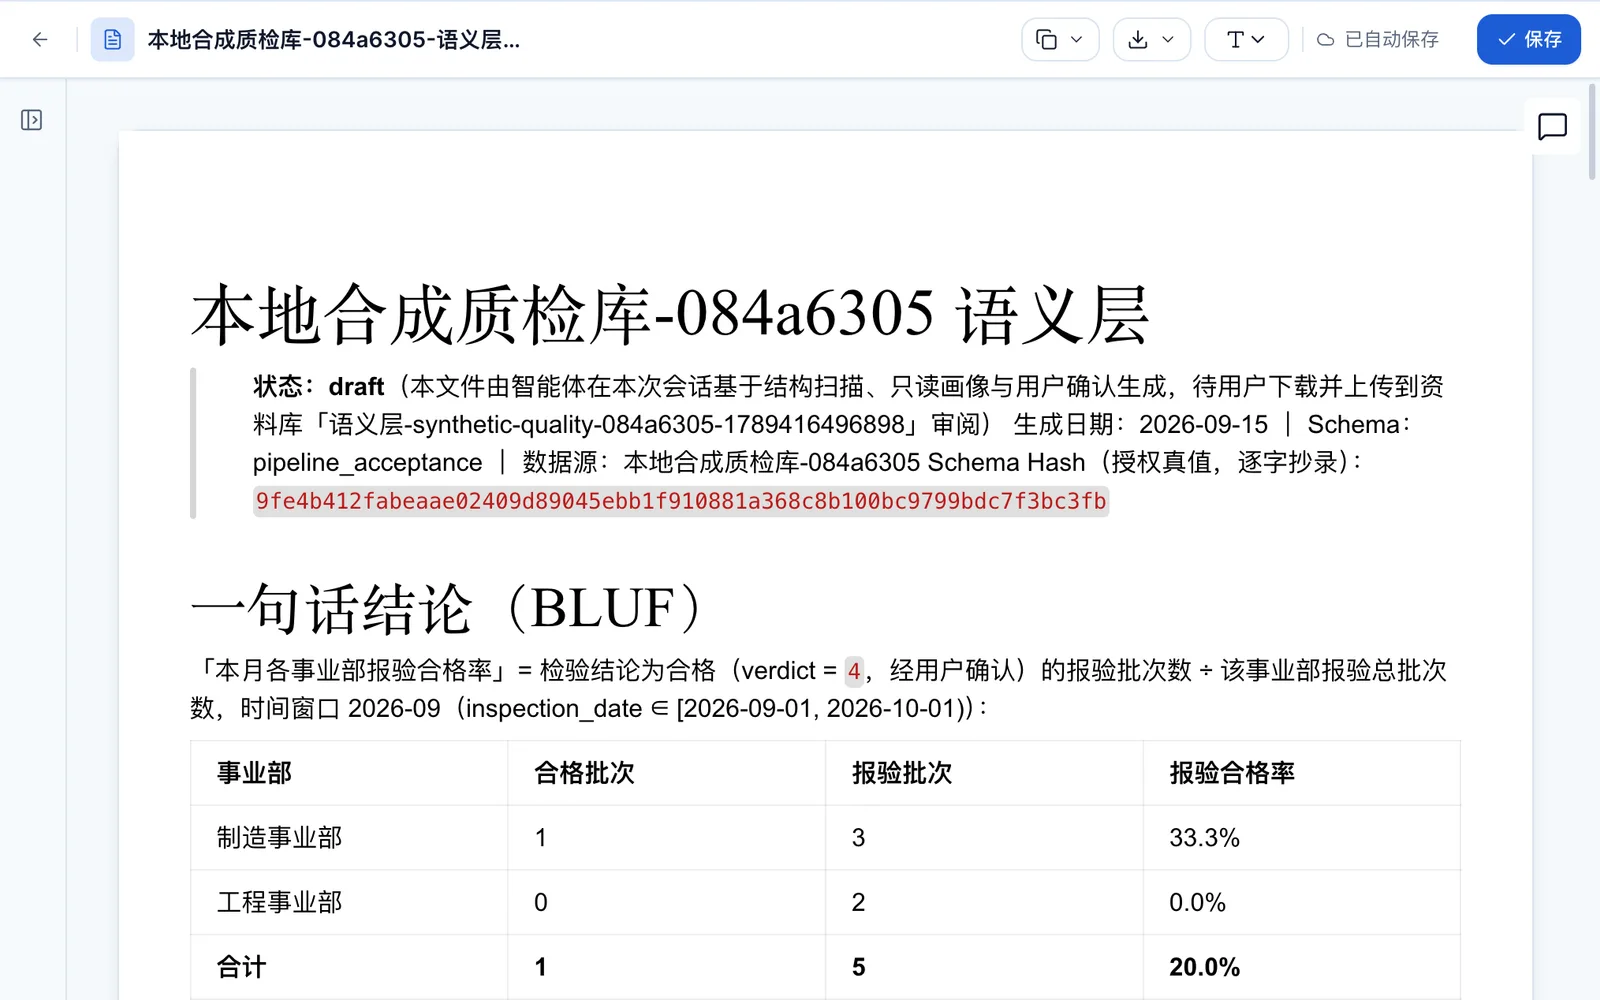
构建完成后,数字员工会报告文档名、覆盖的对象与指标数量、verified 与 proposed 各多少条、实际跑过的核对查询,以及保存状态。文档以草稿状态出现在资料库中,可以像普通文档一样在编辑器里阅读和修改,也可以下载后修改再上传。
只有经过审核且处于启用状态的语义层文档才会被后续问数加载。这一步是有意设计的:数字员工可以起草口径,但让口径生效的是负责该业务的人。审核前,建议对照本单位的质量规定逐条检查代码值与指标定义,并抽一个熟悉的批次核对数字。
每次保存都会核对文档版本。若同事已在此期间修改,编辑器会提示「文档版本已更新,请刷新后再编辑」,不会静默覆盖。数字员工更新文档时遵守同一规则:先读回当前内容再逐条合并,使用者确认过的条目保持原样,有冲突的新证据写进开放问题而不是直接改写。
数据库结构发生变化(例如重新扫描后结构哈希改变)时,数字员工会复核受影响的条目并列出可能过期的确认项,其余内容保留。
按命名指标问数
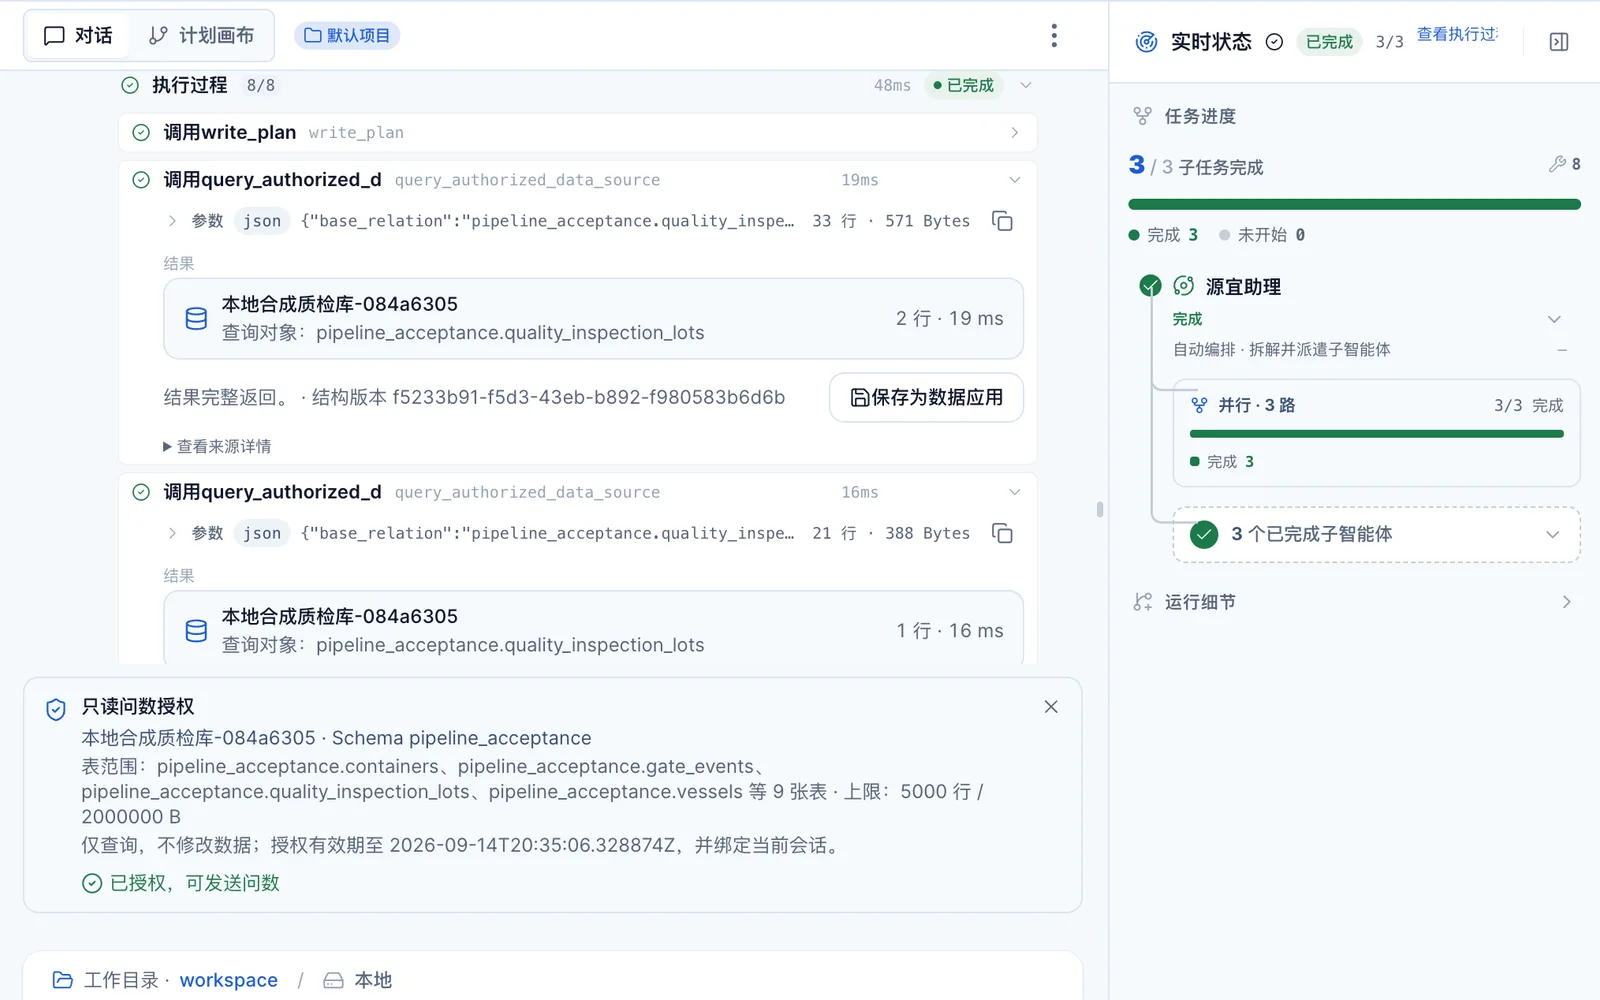
文档启用后,直接用业务语言提问:「本月各事业部报验合格率」。数字员工从文档中取出「报验合格率」的分子、分母与时间字段,按「事业部」分组,生成一条结构化查询;不再需要重新解释合格编码。
每条结果都附带来源信息:查询对象、返回行数、是否完整返回、结构版本,以及展开后的「查看来源详情」。系统同时把本次使用的语义层文档摘要记录到查询账本,之后复核时可以确认这个数字是按哪一版口径算的。
若问到的指标文档里没有,数字员工会如实说明并询问是否新建,而不是自行补一个定义写回资料库。当前版本可直接编译的命名指标为计数与比率两类,支持按日、周、月等时间分桶;求和、均值一类的汇总仍按原字段聚合给出,界面同样显示来源。
追问与诊断:按同一口径重算
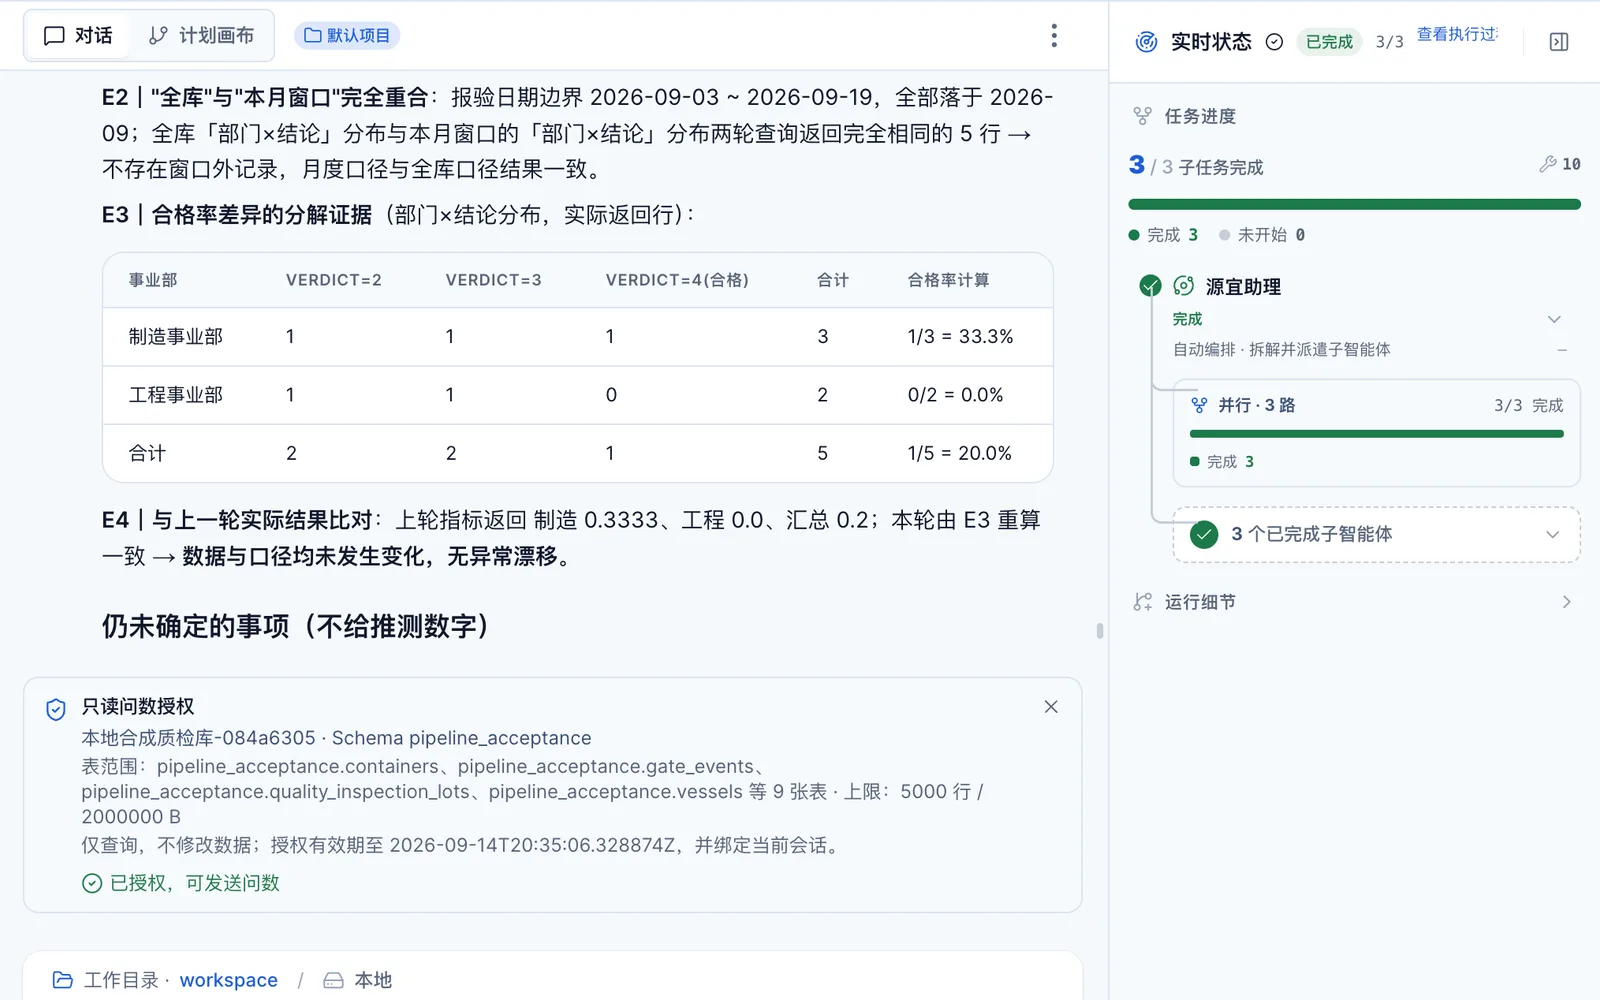
得到数字之后常见的追问是「为什么工程事业部是 0」或「这个月和全库有没有差别」。诊断沿用同一份文档:按事业部与结论编码重算分布,说明每个比率的分子分母来自哪几行,再与上一轮结果逐项比对,指出数据或口径是否发生变化。
图中的例子里,全库五条报验记录都落在当月,因此「本月」与「全库」结果一致;这类结论会连同实际返回的行数一起写出。凡是证据不足以下结论的事项,会放在「仍未确定的事项」中,等待补充数据或使用者说明。
诊断结果可以回写到文档的开放问题或口径说明中,也可以保存为数据应用供团队查看。写回文档时同样经过版本核对与审核流程。
边界与使用建议
这项功能在当前版本中的边界需要事先了解,以便安排适合的场景。
一份经过审核的语义层文档,价值在于之后每一次问数、每一次追问都不必重新解释口径。团队可以把它当作数据口径的公共说明书来维护:新增指标时补一条,规定变化时改一条,并保留审核记录。
- 数据源始终只读;授权限定表范围、行数与字节上限,明细数据不会写入文档。
- 命名指标当前支持计数与比率两类形状;更复杂的汇总先以原字段聚合回答,或在后续版本中扩展。
- 语义层文档只在审核并启用后生效;草稿可以阅读和修改,但不会被问数使用。
- 使用者确认过的条目不会被数字员工改写;结构变化后会收到需要复核的提示。
- 首次构建建议从一个业务问题开始,例如一张台账、一个指标;一次覆盖全库会产生大量待确认项,不利于审核。
要点回顾
- 语义层文档记录的是「怎么算」:业务对象、关系、代码值、指标与开放问题,保存在数据源所在资料库的根目录。
- 数字员工只对会改变结果且证据无法消除的口径提问,提问附带预览;使用者的回答标记为已确认,后续不会被改写。
- 只有审核并启用的文档会被问数使用;保存时核对版本,结果附带结构版本与来源,便于复核。
- 当前命名指标支持计数与比率;从一个业务问题开始构建,逐步扩展。
延伸阅读
想从自己的业务开始?带上一份常用报表和一个最想解决的问题,我们一起看看资料是否够用、第一版应该做到哪一步。
交流您的场景